3C工業質檢大模型的Baseline——Dyson大模型
AI技術在3C工業質檢的核心矛盾是"工業場景對極高穩定性、可靠性和魯棒性的要求"與"AI模型在數據稀缺、環境多變下表現的不確定性"之間的矛盾。3C場景中,缺陷樣貌復雜多變并呈現嚴重的長尾分布,新項目初期缺陷數據稀缺,常規AI模型需要經過漫長的缺陷搜集、數據標注和模型優化過程。即使后期模型具有一定檢測能力,依然難以應對先前未出現的缺陷,此外,若成像、機構等出現變動,模型可能失效。針對常規AI模型在使用過程中的痛點問題,我們結合跨項目數據集和多模態模型的泛化能力,提出一套基于大模型的解決方案。

一.基于跨項目數據治理的模型進化機制
目前,AI視覺技術已在工業質檢領域廣泛應用。針對工業產品的缺陷檢測問題,由于工藝、外力導致的缺陷樣本具有稀缺性和隨機性,缺陷目標相對自然場景,語義信息較弱。工業缺陷數據的特點決定常規AI模型很難處理樣貌變化導致的各類漏檢問題。此外,單個項目甚至單個工位的數據量極其有限。然而借鑒人腦的識別機制,即使新的場景也可以識別到絕大部分異常位置,這說明缺陷信息本身是具有共性的,常規AI模型僅處理單個項目或單個工位,數據之間完全割裂,數據上限被嚴重制約,進一步決定模型泛化能力十分有限。跨項目數據治理的核心動機是進一步提升大模型檢測能力上限,一套嚴密的數據管理機制可以保障模型能力隨時間不斷進化,形成數據、模型能力、設備性能的良性循環。
跨項目數據治理過程中,我們通過特定維度歸納缺陷的共性特征,即使針對不同成像、材質、工藝也可以進行嚴格歸類。圖1中(a),(b)分別展示了不同項目的劃傷和缺口樣本。從缺陷樣貌上觀察,每種類型缺陷類內雖然存在一定差異,但從幾何形態上看,類間區分度也比較明顯。因此,我們從缺陷的本身形態對所有項目樣本進行了新的整理和歸類。由于綜合利用了跨項目數據,缺陷樣本的數量遠遠高于一般針對單個項目甚至單個工位的模型,決定了模型能力可以隨樣本拓展不斷進化。
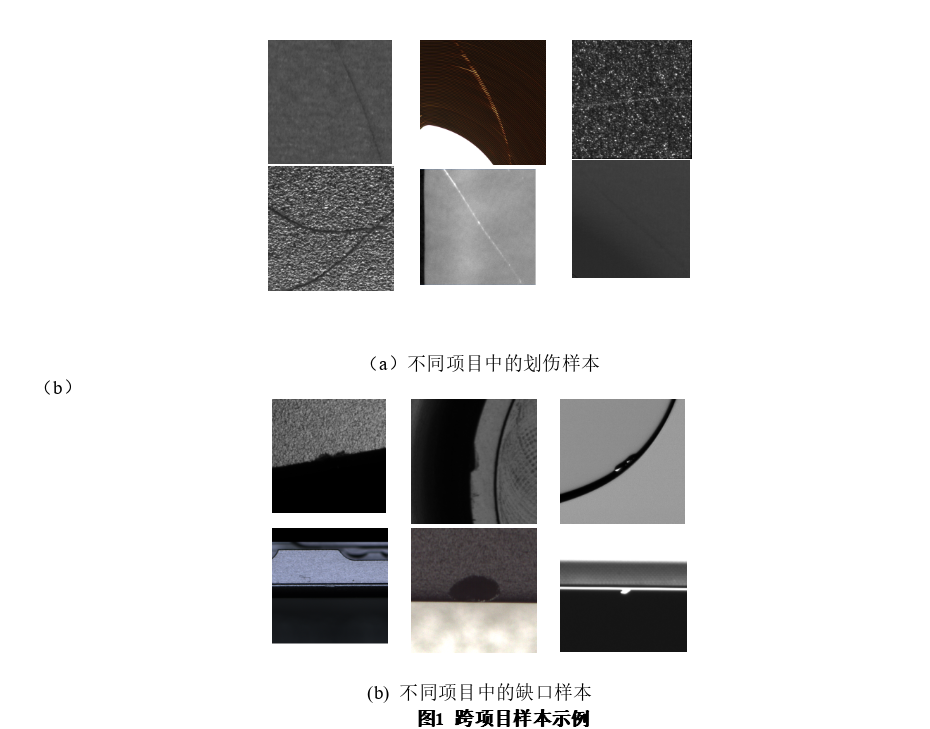
從歸類結果上看,發現單個缺陷的多樣性遠超想象。即使針對圖1中常見缺口缺陷,在不同項目中由于光照條件、拍攝角度、材質、工藝等多種因素影響,呈現出各種隨機變化的樣貌,缺陷樣本的多樣性極大程度上提升了模型的泛化能力,同時經過嚴格歸類的數據一定程度上緩解了缺陷的弱語義特性。
二.多模態模型賦能AI工業質檢
在跨項目大樣本條件下,常規AI模型可能由于模型的復雜度面臨欠擬合風險,基于Transformer架構的Dyson多模態大模型天然具有學習大樣本的能力。我們借鑒人腦在識別事物時結合語言信息的特點,構建了工業場景的學習方案。此外,我們借鑒人腦天然能夠區分不同類別物體,采用自監督方法訓練圖像編碼器,然后通過圖像編碼和文本編碼得到多模態信息,在模型內部通過進一步的對比學習方法得到圖像信息和語言信息的關聯特征。
相比常規的有監督訓練方法,Dyson多模態大模型的訓練方法進一步提升了模型的泛化能力,實測檢測能力接近人類,不但在已訓練場景泛化性更強,而且能夠無需訓練精準識別到新領域的新缺陷。
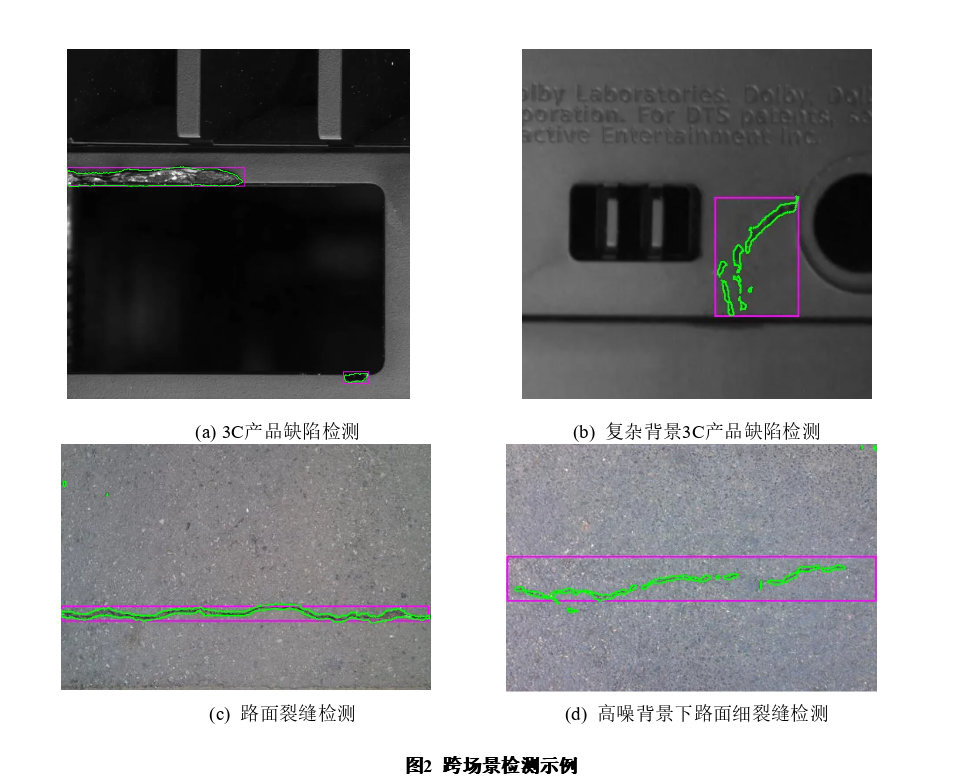
圖2展示了Dyson大模型在跨域條件下的檢測示例,所有該場景樣本完全沒有經過訓練,模型能夠精確定位和分割缺陷目標和背景區域,在子圖(b)中,背景存在大量文字和黑色零件干擾,在子圖(d)中,水泥路面存在大量噪點,裂縫相對正常路面對比度較低,且紋理十分細微。
多模態大模型結構復雜,然而實際機臺PC算力有限。我們在模型原有架構基礎上進行了模型壓縮、算子和模型加速等各種極致效率優化,最終實現毫秒級延遲,實現大模型在單個PC上的本地部署。
三.基于大模型的數據集
征圖深耕檢測領域十幾年,積累原始數據集非常龐大,為現有的大模型提供了大量的優質樣本。數據覆蓋各3C產品線外觀所有工序,成像復雜性和缺陷復雜性對模型能力提出了更高的要求。圖(3)展示了不同成像方案、不同材質的缺陷樣本示例。

四.基于大模型的項目案例
目前,Dyson大模型已在多個項目現場實現落地應用,包括觸摸屏蓋板玻璃、手機邊框、攝像頭模組、新能源電池等場景。相對原有方案,雖然基于大模型的方案在算力消耗上有一定提升,但真實缺陷漏檢率大幅降低,同時針對新場景,由于模型本身具有一定的檢測能力,項目指標收斂周期大幅縮短。例如,在我們的新能源電池場景中,由于光源和成像方案相對已有樣本差異很大,但模型初期即可檢測90%以上缺陷,后期通過各個工位總計200余張缺陷樣本微調即可達到穩定檢測狀態,機臺月度維持0漏檢,綜合良率接近人工檢測。
后記:
我們認為大數據和多模態能力是工業場景恒星級的能量,而Dyson大模型可以利用這種能量賦能工業質檢行業。作為業內首個實現本地部署的工業質檢大模型,于2024年被國家工信部評為年度AI賦能工業應用的典型案例。我們希望以Dyson大模型為baseline,為AI質檢提供更多新方案和思路,和征圖一起,看·見更多不同!
微信公眾號
Copyright 征圖新視(江蘇)科技股份有限公司. All rights reserved 備案號:蘇ICP備17066311號